Prob1 KNNL5.4 KNNL5.12
5.4
We have
Y = [ 7.8 9.0 10.2 11.0 11.7 ] T X = [ 1 1 1 1 1 8 4 0 − 4 − 8 ] T Y=
\begin{bmatrix}
7.8 & 9.0 & 10.2 & 11.0 & 11.7
\end{bmatrix}^T\\
X=
\begin{bmatrix}
1 & 1 & 1 & 1 & 1 \\
8 & 4 & 0 & -4 & -8
\end{bmatrix}^T
Y = [ 7.8 9.0 10.2 11.0 11.7 ] T X = [ 1 8 1 4 1 0 1 − 4 1 − 8 ] T
therefore
Y T Y = 503.77 X T X = [ 5 0 0 160 ] X T Y = [ 49.7 − 39.2 ] Y^TY=503.77\\
X^TX=
\begin{bmatrix}
5 & 0 \\
0 & 160
\end{bmatrix}\\
X^TY=
\begin{bmatrix}
49.7 \\
-39.2
\end{bmatrix}
Y T Y = 503.77 X T X = [ 5 0 0 160 ] X T Y = [ 49.7 − 39.2 ]
5.12
( X T X ) − 1 = [ 1 5 0 0 1 160 ] (X^TX)^{-1}=
\begin{bmatrix}
\frac{1}{5} & 0 \\
0 & \frac{1}{160}
\end{bmatrix}
( X T X ) − 1 = [ 5 1 0 0 160 1 ]
Prob2 KNNL 5.23
2-a
Estimated regression coefficients
b = ( X T X ) − 1 X T Y = [ 9.94 − 0.245 ] b=(X^TX)^{-1}X^TY=
\begin{bmatrix}
9.94 \\
-0.245
\end{bmatrix}
b = ( X T X ) − 1 X T Y = [ 9.94 − 0.245 ]
Vector of residuals
e = Y − X b = [ − 0.18 0.04 0.26 0.08 − 0.2 ] T e=Y-Xb=\begin{bmatrix}
-0.18 & 0.04 & 0.26 & 0.08 & -0.2
\end{bmatrix}^T
e = Y − X b = [ − 0.18 0.04 0.26 0.08 − 0.2 ] T
SSR
S S R = ∥ X b − Y ˉ ∥ 2 = 9.604 SSR=\|Xb-\bar{Y}\|^{2}=9.604
S S R = ∥ X b − Y ˉ ∥ 2 = 9.604
SSE
S S E = ∥ e ∣ ∣ 2 = 0.148 SSE=\|e||^{2}=0.148
S S E = ∥ e ∣ ∣ 2 = 0.148
Estimated variance-covariance matrix of b b b
C o v ^ ( b ) = M S E ⋅ ( X T X ) − 1 = [ 0.00986667 0 0 0.00030833 ] \widehat{\mathrm{Cov}}(b)=MSE\cdot(X^TX)^{-1}=
\begin{bmatrix}
0.00986667 & 0 \\
0 &0.00030833
\end{bmatrix}
Cov ( b ) = M S E ⋅ ( X T X ) − 1 = [ 0.00986667 0 0 0.00030833 ]
Point estimate of E [ Y h ] \mathbb{E}[Y_{h}] E [ Y h ] X h = − 6 X_{h}=-6 X h = − 6
Y ^ h = [ 1 − 6 ] b = 11.41 \hat{Y}_{h}=\begin{bmatrix}
1 & -6
\end{bmatrix}b=11.41
Y ^ h = [ 1 − 6 ] b = 11.41
Estimated variance of Y ^ h \hat{Y}_{h} Y ^ h X h = − 6 X_{h}=-6 X h = − 6
V [ Y ^ h ] = σ 2 ⋅ x T ( X T X ) − 1 X T ⋅ X ( X T X ) − 1 x = σ 2 ⋅ x T ( X T X ) − 1 x V ^ [ Y ^ h ] = M S E ⋅ x T ( X T X ) − 1 x = 0.02096 \mathbb{V}[\hat{Y}_{h}]=\sigma^{2}\cdot x^T(X^TX)^{-1}X^T\cdot X(X^TX)^{-1}x=\sigma^{2}\cdot x^T(X^TX)^{-1}x\\
\hat{\mathbb{V}}[\hat{Y}_{h}]=MSE\cdot x^T(X^TX)^{-1}x=0.02096
V [ Y ^ h ] = σ 2 ⋅ x T ( X T X ) − 1 X T ⋅ X ( X T X ) − 1 x = σ 2 ⋅ x T ( X T X ) − 1 x V ^ [ Y ^ h ] = M S E ⋅ x T ( X T X ) − 1 x = 0.02096
2-b
X T X X^TX X T X
2-c
H = X ( X T X ) − 1 X T = [ 0.6 0.4 0.2 0.0 − 0.2 0.4 0.3 0.2 0.1 0.0 0.2 0.2 0.2 0.2 0.2 0.0 0.1 0.2 0.3 0.4 − 0.2 0.0 0.2 0.4 0.6 ] H=X(X^TX)^{-1}X^T=
\begin{bmatrix}
0.6 & 0.4 & 0.2 & 0.0 & -0.2 \\
0.4 & 0.3 & 0.2 & 0.1 & 0.0 \\
0.2 & 0.2 & 0.2 & 0.2 & 0.2 \\
0.0 & 0.1 & 0.2 & 0.3 & 0.4 \\
-0.2 & 0.0 & 0.2 & 0.4 & 0.6
\end{bmatrix}
H = X ( X T X ) − 1 X T = 0.6 0.4 0.2 0.0 − 0.2 0.4 0.3 0.2 0.1 0.0 0.2 0.2 0.2 0.2 0.2 0.0 0.1 0.2 0.3 0.4 − 0.2 0.0 0.2 0.4 0.6
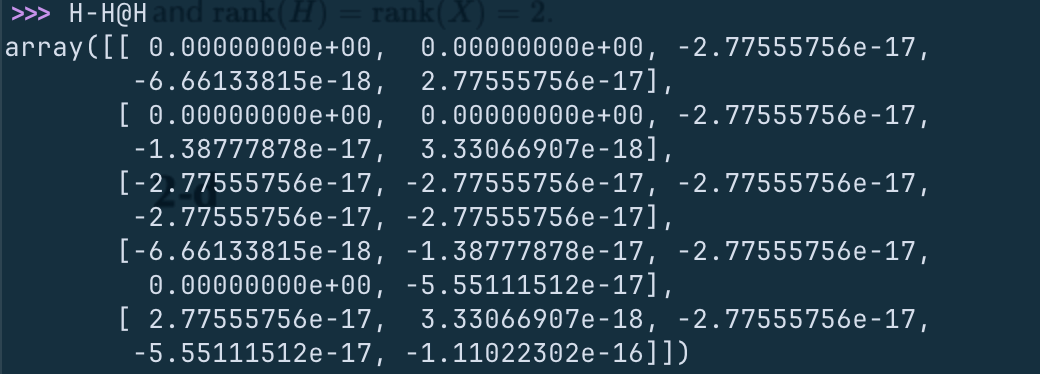
and r a n k ( H ) = r a n k ( X ) = 2 \mathrm{rank}(H)=\mathrm{rank}(X)=2 rank ( H ) = rank ( X ) = 2
Verify H H H
2-d
C o v ( e ) = σ 2 ( I − H ) \mathrm{Cov}(e)=\sigma^{2}(I-H)
Cov ( e ) = σ 2 ( I − H )
therefore
s 2 ( e ) = M S E ⋅ ( I − H ) = [ 0.019733 − 0.019733 − 0.009867 0.000000 0.009867 − 0.019733 0.034533 − 0.009867 − 0.004933 0.000000 − 0.009867 − 0.009867 0.039467 − 0.009867 − 0.009867 0.000000 − 0.004933 − 0.009867 0.034533 − 0.019733 0.009867 0.000000 − 0.009867 − 0.019733 0.019733 ] s^{2}(e)=MSE\cdot(I-H)=
\begin{bmatrix}
0.019733 & -0.019733 & -0.009867 & 0.000000 & 0.009867 \\ -0.019733 & 0.034533 & -0.009867 & -0.004933 & 0.000000 \\ -0.009867 & -0.009867 & 0.039467 & -0.009867 & -0.009867 \\ 0.000000 & -0.004933 & -0.009867 & 0.034533 & -0.019733 \\ 0.009867 & 0.000000 & -0.009867 & -0.019733 & 0.019733 \\
\end{bmatrix}
s 2 ( e ) = M S E ⋅ ( I − H ) = 0.019733 − 0.019733 − 0.009867 0.000000 0.009867 − 0.019733 0.034533 − 0.009867 − 0.004933 0.000000 − 0.009867 − 0.009867 0.039467 − 0.009867 − 0.009867 0.000000 − 0.004933 − 0.009867 0.034533 − 0.019733 0.009867 0.000000 − 0.009867 − 0.019733 0.019733
Bonus Question
Let
X = [ X 1 … X n ] T , a = [ a 1 … a n ] T X=
\begin{bmatrix}
X_{1} & \dots & X_{n}
\end{bmatrix}^T,\, a=
\begin{bmatrix}
a_{1} & \dots & a_{n}
\end{bmatrix}^T
X = [ X 1 … X n ] T , a = [ a 1 … a n ] T
Then
Y = a T X , E [ X ] = 0 , V a r ( X ) = [ 1 p … p p 1 … p ⋮ ⋮ ⋱ ⋮ p p … 1 ] Y=a^TX,\ \mathbb{E}[X]=0,\ \mathrm{Var}(X)=
\begin{bmatrix}
1 & p & \dots & p \\
p & 1 & \dots & p \\
\vdots & \vdots & \ddots & \vdots\\
p & p & \dots & 1
\end{bmatrix}
Y = a T X , E [ X ] = 0 , Var ( X ) = 1 p ⋮ p p 1 ⋮ p … … ⋱ … p p ⋮ 1
So
E [ Y ] = a T E [ X ] = 0 V [ Y ] = a T V a r [ X ] a = a T ( ( 1 − p ) I + p 1 1 T ) a = ( 1 − p ) ∑ i = 1 n a i 2 + p ( ∑ i = 1 n a i ) 2 \mathbb{E}[Y]=a^T\mathbb{E}[X]=0\\
\mathbb{V}[Y]=a^T\mathrm{Var}[X]a=a^T((1-p)I+p\boldsymbol{1}\boldsymbol{1}^T)a=(1-p)\sum_{i=1}^{n} a_{i}^{2}+p\left( \sum_{i=1}^{n} a_{i} \right)^{2}
E [ Y ] = a T E [ X ] = 0 V [ Y ] = a T Var [ X ] a = a T (( 1 − p ) I + p 1 1 T ) a = ( 1 − p ) i = 1 ∑ n a i 2 + p ( i = 1 ∑ n a i ) 2
Let S 1 = ∑ a i 2 , S 2 = ( ∑ a i ) 2 S_{1}=\sum a_{i}^{2},S_{2}=\left( \sum a_{i} \right)^{2} S 1 = ∑ a i 2 , S 2 = ( ∑ a i ) 2 n S 1 ≥ S 2 nS_{1}\geq S_{2} n S 1 ≥ S 2 p p p V [ Y ] ≥ 0 , ∀ a ∈ R n \mathbb{V}[Y]\geq 0,\ \forall a\in \mathbb{R}^{n} V [ Y ] ≥ 0 , ∀ a ∈ R n
When S 1 ≤ S 2 S_{1}\leq S_{2} S 1 ≤ S 2 p p p
p ≥ S 1 S 1 − S 2 = 1 1 − S 2 / S 1 ≥ 1 1 − n p\geq \frac{S_{1}}{S_{1}-S_{2}}=\frac{1}{1-S_{2}/S_{1}}\geq \frac{1}{1-n}
p ≥ S 1 − S 2 S 1 = 1 − S 2 / S 1 1 ≥ 1 − n 1
When S 1 > S 2 S_{1}>S_{2} S 1 > S 2 p p p
p ≤ S 1 S 1 − S 2 p\leq \frac{S_{1}}{S_{1}-S_{2}}
p ≤ S 1 − S 2 S 1
which is guaranteed because p ≤ 1 p\leq 1 p ≤ 1 S 1 S 1 − S 2 > 1 \frac{S_{1}}{S_{1}-S_{2}}> 1 S 1 − S 2 S 1 > 1
So in all, the minimum of p p p 1 1 − n \frac{1}{1-n} 1 − n 1
Think a bit deeper about this conclusion: if we want to impose a shared correlation on n n n n = 3 n=3 n = 3 − 1 -1 − 1 X 1 X_{1} X 1 X 2 X_{2} X 2 X 2 X_{2} X 2 X 3 X_{3} X 3 X 3 X_{3} X 3 X 1 X_{1} X 1 X 1 X_{1} X 1 X 3 X_{3} X 3