LINE
对于以下线性模型
Yi=β0+β1Xi+εi
要求
- E(εi)=0, ∀i,这总可以通过调整截距项来做到
- Var(εi)=σ2, ∀i,同方差,这是假设
- εi,εj 不相关,也是假设
Xi 在经典理论里不被看作是随机变量,被看作是随机变量时才有内生性之类的问题。本课通通将 Xi 看作已知数而非随机变量。
我觉得,若视 Xi 为随机变量,把以后所有结论都看作是给定所有 Xi 的条件下的结论,应与视其为已知数的情况是相容的。我更愿意把 Xi 看成是随机变量,以下也全部从这个视角出发做笔记。
进一步假设 ε1,…,εn∣X∼i.i.d.N(0,σ2),则上模型等价于说:
Y1,…,Yn are independent and for each i, Yi∣X∼N(β0+β1Xi,σ2)
总结就是:
- Linear Function: E[Y∣X] is linear.
- Independent: given all design variables Xi, εi's are independent
- Normally Distributed: εi∣X is normal for all i's
- Equal Variances: Var(εi∣X)'s are equal
Parameter Estimation
Parameters to be estimated: β0,β1,σ2
LS Estimation
Estimation
最小二乘估计:
β0^,β1^=argminβ0,β1∑(Yi−β0−β1Xi)2
结果是
β^1β^0=SxxSxy=Yˉ−β^1Xˉ
提供一个看 β^1 的视角:
β^1=i=1∑NSxxXi−XˉYi
可以把 β^1 看作是 Yi 的一个加权和,权重为 SxxXi−Xˉ. 用法见 异方差下斜率估计量的方差。
拟合模型为
Y^i=β^0+β^1Xi
定义残差为
ei=Yi−Y^i
残差有以下统计性质:
- ∑ei=0
- ∑Xiei=0
这两个性质可以推出
- ∑Yi=∑Y^i
- ∑Y^iei=0
下面估计 σ2
Note that Var(Yi)=σ2, can we estimate σ2 with
n−1∑(Yi−Yˉ)2?
No. Because Yi's are not i.i.d..
注意 σ2=Var(εi)=E(ε2),而 ei 是 εi 的好代理,因此可以用
n∑ei2
来估计,不过这个估计不是无偏的,ei 的两个统计性质用掉了 2 个自由度,因此
s2=σ^2=n−2∑ei2=dfESSE=MSE
是 σ2 的无偏估计。这个的证明见这里,不是很显然,要算一算。
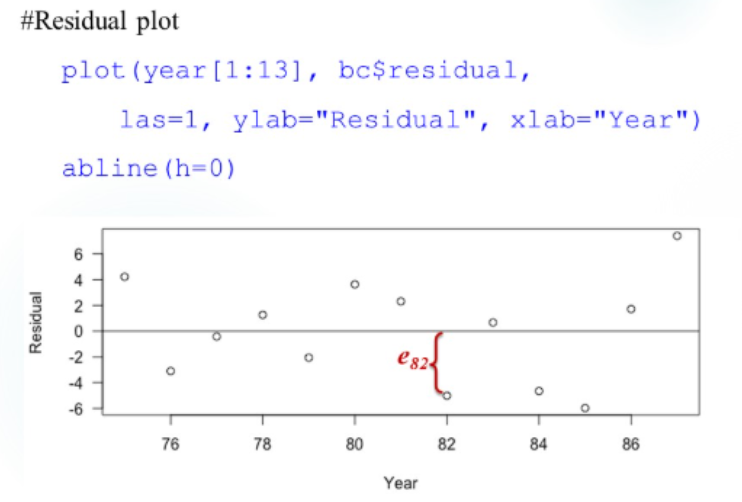
Residual Plot
The residuals not only tell about the errors, but also how well the model fits data.
因为我们的假设大部分都是对误差项做的,若这些假设都对,残差应是误差的好代理,我们期望它跟误差有相像的行为。
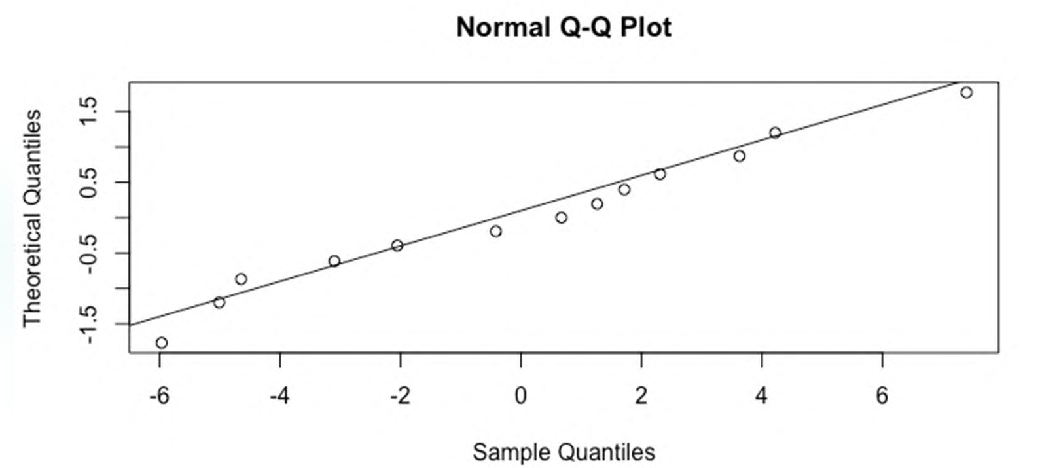
QQ plot. Empirical cdf v.s. theoretical cdf.
ML Estimation
似然准则:在统计模型给定的情况下,关于模型参数的所有信息都被似然函数包含,即根据似然函数就可以估计参数。
以下计算均是给定 X 而言,在此声明,以省略 ∣X 的书写。
首先确定统计模型:
Yi∼N(β0+β1Xi,σ2)
再确定似然函数:
L(β0,β1,σ2∣Y)=f(Y∣β0,β1,σ2)=i=1∏nfi(⋯)
解
argmaxβ0,β1,σ2L(β0,β1,σ2∣Y)
得
β^0ML,β^1MLσ^2,ML=β^0LS,β^1LS=n∑ei2=σ^2,LS
- ML estimates rely on distributional assumptions, LS estimates do not
- In general, MLEs and LSEs are different