收益率模型:获取“阿尔法”
通篇也就最后引出的超额收益经验法则有点意思。
以下把因子称为预测变量,原书区分了两种叫法,阐明学术界和业界的不同叫法。
寻找预测变量
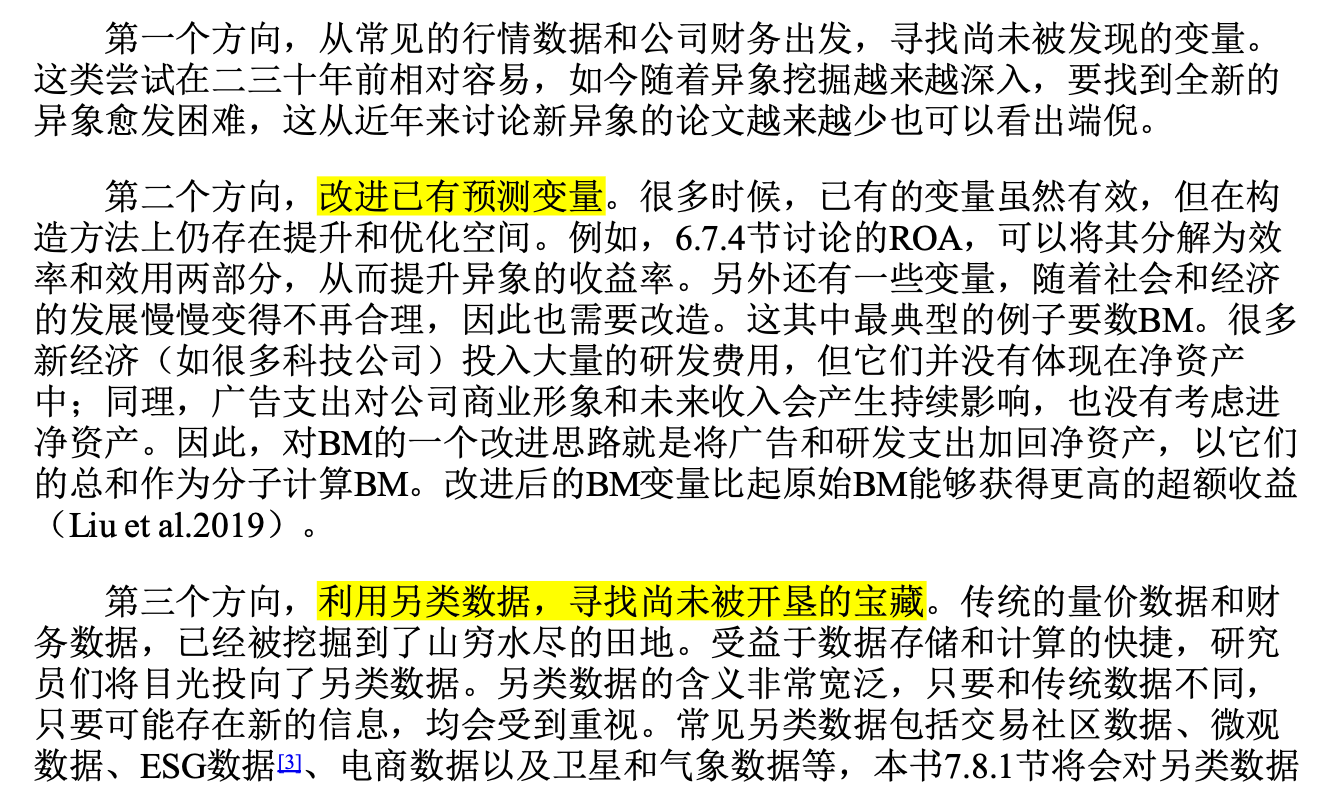
看看,找新因子早在石川写这本书的时候就已经到山穷水尽的地步了。还是得改进或者开辟新土壤,改进我看需要对公司、市场的深度理解或者独到且正确的见解;开辟新土壤,一个例子就是幻方搞出了 DeepSeek。
挑选预测变量
有以下的评判角度
逻辑性
检查是否有风险补偿和错误定价角度的解释。
如果从上述两个方面都无法解释,那么某个预测变量很可能仅仅是针对样本内的数据窥探导致。
持续性
IC、投资组合排序。
信息增量性
变量相关性、条件排序以及 Fama–MacBech 回归都是常见的方法
正交化
稳健性
预测变量的计算参数、算法和样本若发生变化,其性能会否大变。
可投资性
变量的信息衰减速度决定了使用该变量交易时的换仓频率和策略容量。
衰减快,会导致高换手率,交易成本也高。
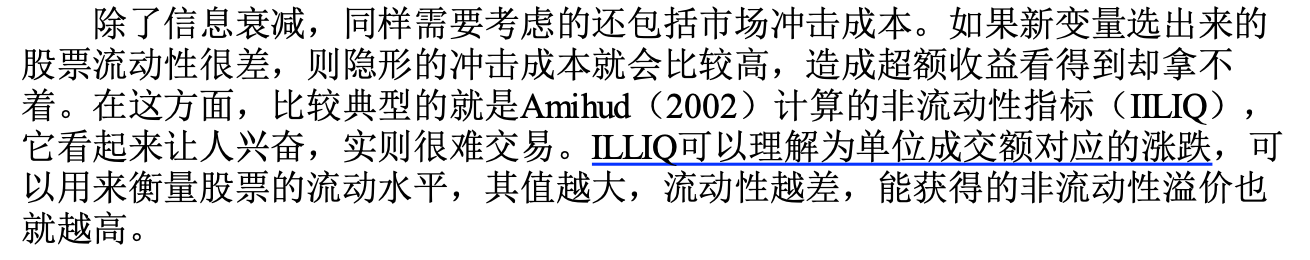
这个 ILLIQ 跟周哥讲的那个模型——每 1000 手交易导致的收益率是独立同分布——有点像,是不是有关系?
普适性
A 股能用,美股也能用。
收益率预测
确定投资范围
- 确定原始股票池
- 全市场
- 行业成分
- 指数成分
- 优化股票池,剔除有缺陷的股票
- 低流动性
- 高风险(待退市股、次新股等等)
- 大概率跑输
低流动性股票冲击成本大:订单簿浅,进场时产生两种冲击:
- 瞬时冲击:击穿卖盘档位,造成滑点损失
- 永久冲击:消耗了稀缺的流动性,后续买盘价格被永久抬高
剔除预测变量异常值
- 缩尾法:按百分位数剔除极大/极小值
- 三倍标准差法
- 绝对中位差法(Median Absolute Deviation):标准差法的稳健版本,类似中位数和平均数的差别
非参数化预测
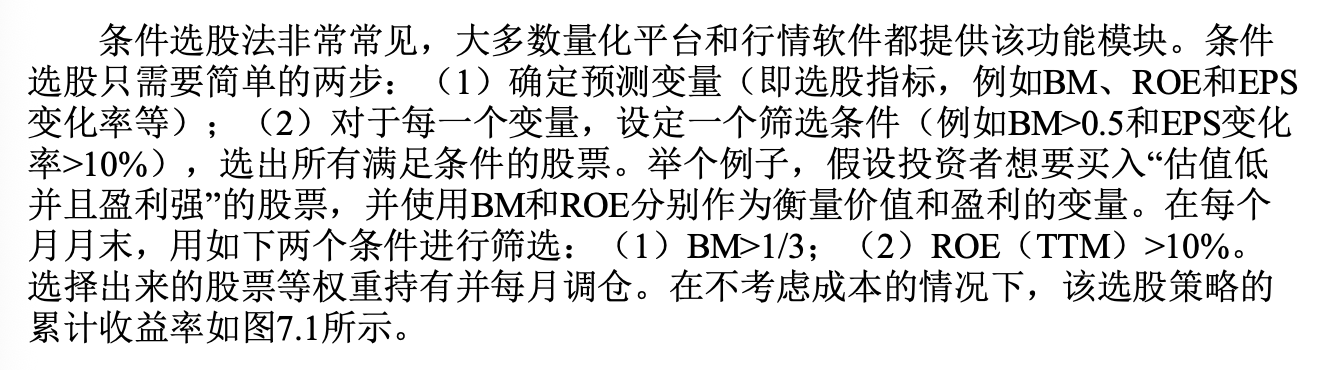
原始人方法。
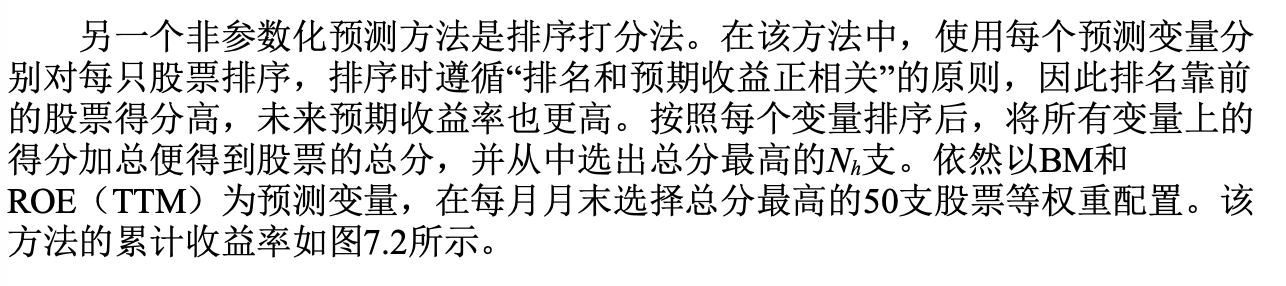
又一个原始人方法。
参数化预测
有 个预测变量,每个预测变量在截面上计算 z-score,得到 ,然后计算综合 z-score: ,其中 是权重,跟因子择时有关。然后做截面回归:
得到 。因为每一期都能做回归,就可以得到时间序列 和 。然后取均值作为 的预测,结合最新的 ,预测 .
还有一种做法是做面板回归,直接得到 。
用 OLS 求解上面的一元回归,得到对超额收益的估计:
这正是 Grinold(1994)提出的著名的超额收益经验法则,也就是 三要素公式。(注意第一项就是 IC)
总结就是:把各种因子值合成为一个值,再把这个值作为一元线性模型的解释变量,预测个股收益率。第一步合成,现代是不是有更先进的做法,比如深度学习?还有一个问题:为什么最后非要用线性模型预测收益率?
回答:因为因子本身就是高质量的信号,最后的学习器不用很复杂,trash in trash out。
该经验法则是 Grinold 进一步推导主动管理基本定律()以及均值-方差最优化组合权重设定的底层微观基础