考虑之前介绍过的回归方法,第二步回归解释变量用的是 β^i ,不是真实的暴露,所以这里存在解释变量的误差(errors in variables),计量中学过,这可能是要破坏估计量的无偏和一致性的。
于是有两种主流解决方法:
引入工具变量
先给出模型:
Rite=γt+β^iλt+αit,i=1,2,…,N
令
Rte=R1te⋮RNte,β^E=β^1T⋮β^NT,αt=α1t⋮αNt
再定义 N×(K+1) 矩阵 B^E=[1N,β^E] 和 K+1 维向量 ξt=[γt,λ1t,…,λKt] ,上面的模型就可以写成
Rte=B^Eξt+αt
为减少EIV问题的影响, Jegadeesh et al.(2019) 在估计上面模型的 ξt 中引入了工具变量, 得到 ξt 的IV估计量:
ξ^IV,t=(B^ITB^E)−1(B^ITRte)
式中 B^I=[1N,β^I] 是 B^E 的工具变量。
...
使用公司特征
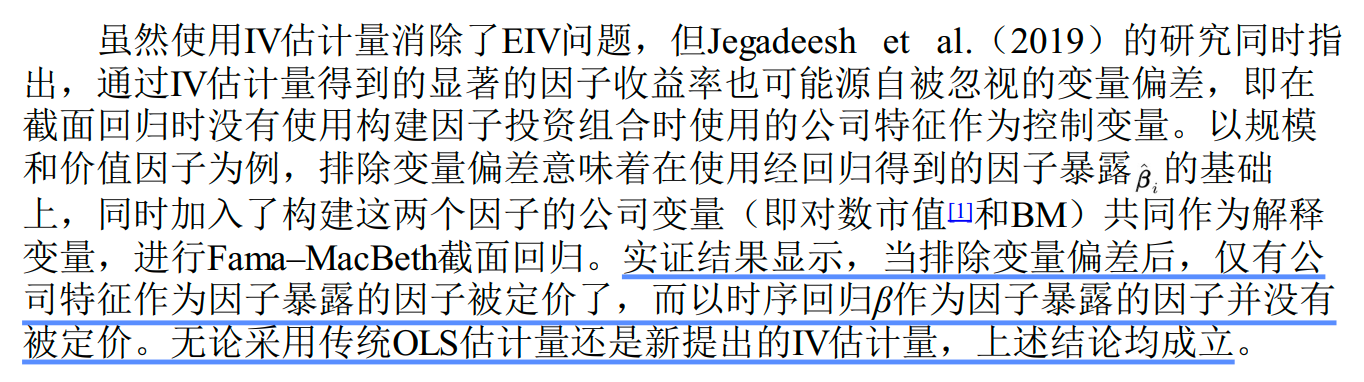
还是同一篇论文,说加入遗漏变量做回归后,原来的暴露 β^i 变🤡了。
所以我感觉这论文主要是想说,用时序回归估计暴露是小丑做法,石川大哥你怎么单列出来一节?好像这方法很好使似的。
看这个表格:
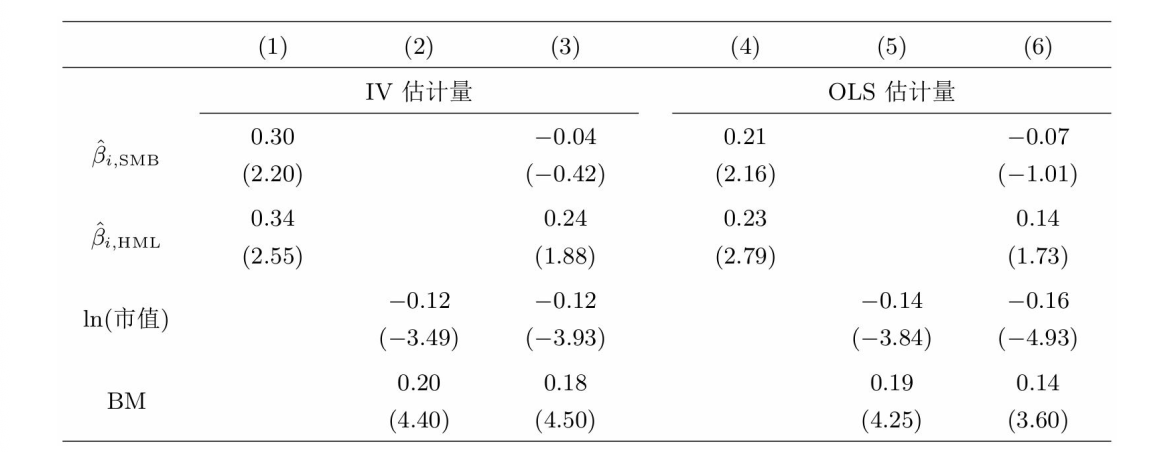
说明文字:
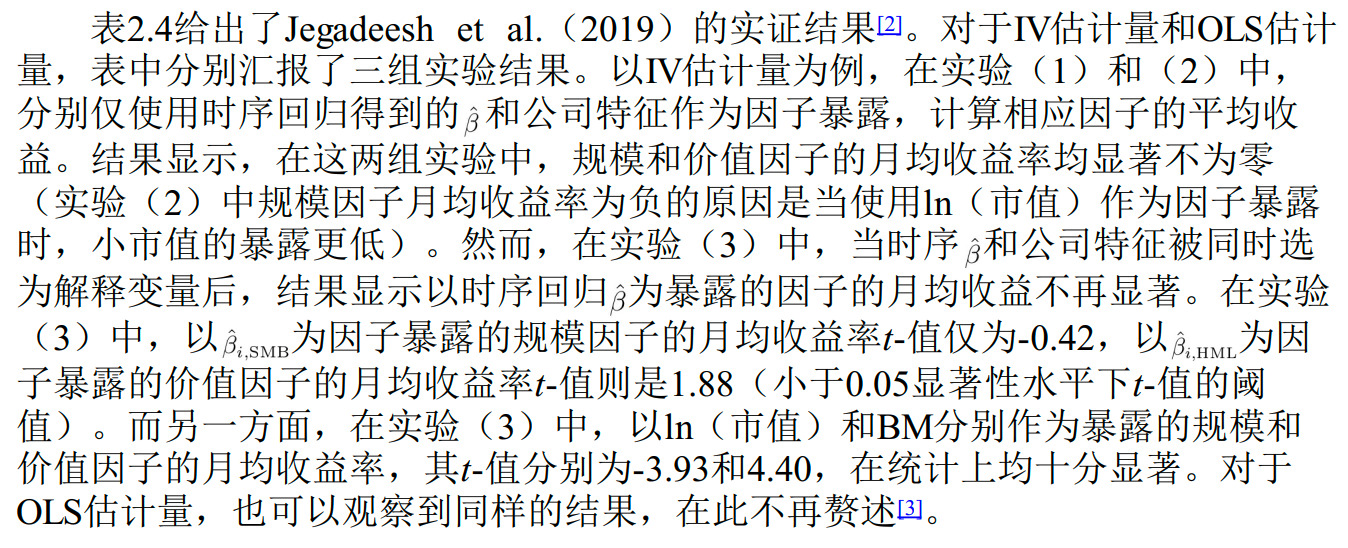
总之就是:直接用公司特征好。
两类模型
当使用个股作为测试资产时, 以公司特征作为因子暴露则“完胜”时序回归得到的 :前者能获得显著风险溢价, 但后者却不行。
直接用公司特征作为个股在因子上的暴露,这种模型叫做截面多因子模型。
Fama and French(2020) 回答了这个问题,其核心结论为, 比起传统的“时序回归多因子模型”, “截面回归多因子模型”更能解释资产收益率的预期差异, 即资产的定价误差更接近零。
此外, 当使用“截面回归多因子模型”时, 因子暴露应使用时变的公司特征, 而非恒定的公司特征(比如对于某公司, 把它的某个特征在时序上取均值, 但这种方法效果并不好)