保研面经
用完之后我将躺平。
知识面
标准误是什么?和标准差有什么区别?
标准误就是统计量的标准差。不过这个问题应该是想考察对总体分布和抽样分布的理解。
标准差是衡量总体分布分散程度的指标,而标准误是衡量估计量所服从的抽样分布的分散程度。
知道几种收敛?
这些收敛各自有什么用?
依概率收敛最有名的应用是弱大数定律,以及用于估计量一致的定义。
几乎必然收敛则常用于强大数定律。
依分布收敛常用于中心极限定理。
均方收敛也是在评价估计量(MSE,均方误差)的时候遇见的。
大数定律和中心极限定律都有各自的适用条件,请你回答一下
大数定律:
独立同分布,有限均值和方差。
中心极限定理:
独立同分布,有限均值和方差。
另外还有 Lyapunov's CLT:
独立,满足 Lyapunov's condition,不用同分布。
最小二乘估计和MLE有什么关系和区别?
当预测误差(噪声)严格服从独立同分布的正态分布时,最小二乘估计就是极大似然估计。
遗漏 , 的系数如何变化?
的系数代表 在控制其他变量的情况下对 的影响,遗漏 即不控制它,而随 增加 也会随之增加,即二者呈正相关。在遗漏变量的模型中, 的系数除了代表 的影响,还包含了 的间接影响。更加清晰的链路如下: 增加,一方面使 增加,一方面使 增加,而 的增加又使 增加,因此遗漏变量模型中 的系数会上偏。
若 和 没有关系, 的系数会被影响吗?
不会
除了 和 的关系,还有什么影响系数?
两者与 的关系。
学过哪些点估计的方法?
矩估计、极大似然估计。
置信区间和假设检验的联系?
双边假设检验与置信区间有对偶关系。给定同样的显著性水平,拒绝原假设等价于原假设对应的点在置信区间之外。
给定服从均匀分布的随机变量,怎么变换成正态分布?
若 ,则 .
测量误差带来的影响?
内生性。
内生性还有哪些来源?
遗漏变量、样本选择、同时性。
样本选择带来内生性的例子:
考虑教育年限 对女性薪资 的影响:
注意这里收集到的样本只能是在就业市场的女性。考虑另一个变量,比如情商,它被囊括进 ,在就业市场中的女性,如果她教育年限低,那么她大概率情商很高,否则她几乎不会留在就业市场,也就不会出现在样本中。反过来,如果教育年限高,那低情商是被允许的。因此情商就跟 有负相关,导致了内生性。
样本选择问题, 少选了部分样本和 少选了部分样本,对估计的影响。
还是考虑教育年限 对女性薪资 的影响:
少选了样本,比如说只考虑教育年限大于10年的女性,这种情况下 仍然是零(假设上面的模型是真实的),所以估计仍然是无偏且一致的。但是 的变异会少,这导致估计的方差变大。
少选了样本,比如说只考虑在就业市场的女性,即只考虑 的样本,这就会导致上一个回答中的内生性问题。
面板数据为什么不建议用 OLS?
同一个体不同时间段的数据一般具有相关性,破坏了OLS的假设,可以看概统拾遗 › Intra-Cluster Correlation in Linear Regression。
最大似然估计和OLS估计的区别是什么?最大似然估计有什么优势?
区别:
- OLS目标是最小化误差平方和,极大似然估计目标是最大化似然函数
- OLS 不需要模型假设,MLE需要假设分布
优势:
- MLE应用更广,OLS主要用于线性回归
- 如果分布假设正确,MLE有优秀的大样本性质,是不赖的估计量(方差达到 Cramer-Rao 下界、一致)
简历面
校团委舆情监督项目
介绍一下做了什么?
背景:
- 校团委,舆情监控
- 导员(博士生)邀请进组
做了什么:
- 把爬到的数据做结构化,按日期排序
- 计算TF-IDF矩阵,绘制词云图
- 用snowNLP计算情感得分,绘制每日平均值
取得什么结果:
- 学会了使用python,jupyter notebook
- 工程实现能力up
- 对自然语言处理有基本认知
纯文本舆情分析存在哪些局限性?如果让你优化,你会补充哪些维度?
帖子的收藏数,图片信息等。
ai agent 开发项目
做了什么?
背景:
- 计算机组成及网络原理的课程大作业
- 本来有“写一个文件管理器”、“邮件服务”的选项,为顺应时代发展,选择了ai agent项目
做了什么:
- 自行完成了ai对话的服务端和客户端(CLI应用)
- 写了爬取网易云音乐每日推荐的python脚本,注册进服务端的tools列表,接入mcp以供模型调用
收获:
- 了解agent工作流
- 工程能力up
"推荐解释准确性"如何解释?
不用我写的mcp工具,告诉llm我喜欢的音乐类型之后,直接让llm给我推荐音乐,和使用mcp工具的结果进行对比,听下来对我口味的歌曲确实变多了。
首都机场实习
做了什么?
做了什么:
- 收集METAR天气报文,做结构化处理(统一时区、按时间排序...)
- 量化天气数据
- 做线性回归 每半小时平均航班延误时长 半小时内各天气指标(云量、降雨量、风速)的恶劣分数
- 事件回测,计算机场韧性
收获:
- 工程能力up
- 感受到数据分析是如何运用到业务中的
- 必须要跟实际结合(
韧性指数如何定义?
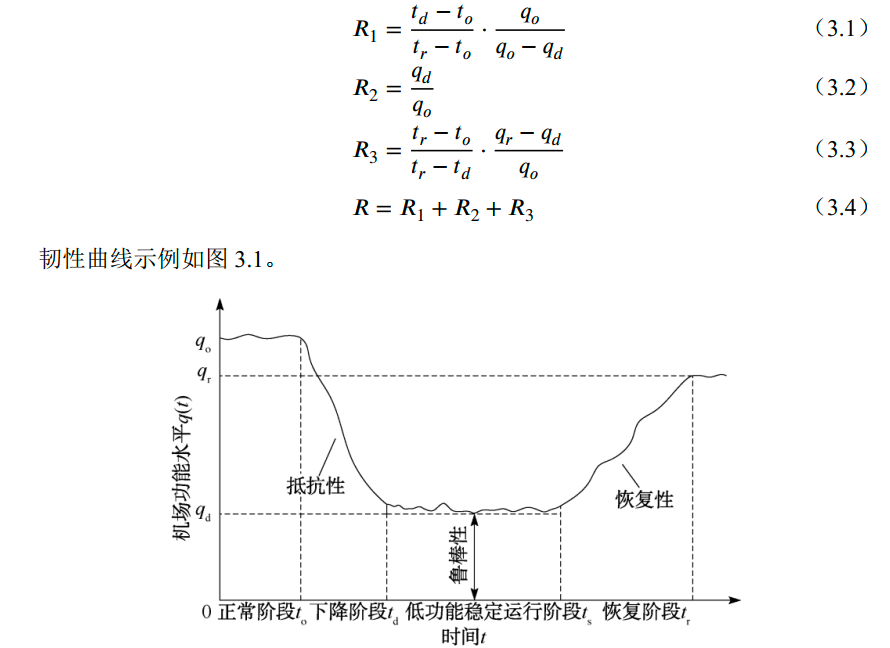
如何帮助调度决策?
跟数据部门主管聊的时候,他说可以用我们这个模型进行预测。首都机场和大兴机场距离较远,天气情况不一样,可以提前调度航班到不同的机场。
百度实习
做了什么?
做了什么:
- 支持产品经理的数据分析需求
- 开发 NL2SQL agent 工作流
收获:
- 了解互联网企业如何利用数据做决策(数字化优势),和传统企业不同
- 增强了工程能力(agent 开发)
怎么解决AI agent可能存在的幻觉等其他问题?
RAG,用更强的模型
你在数据跟踪过程中,是否发现过和业务预期不符的异常数据?你是如何排查和解决的?
我负责的搜有红包开屏统计数据(uv,pv,...)在年前突然暴跌至零,我以为是我的任务出现问题,排查之后发现任务正常运行,但数据确实是0,然后去问mentor,原因是搜有红包被并入26CNY活动,记录字段改变了。
遇到的最大的困难是什么,怎么克服的?
之前选用的是 crewai 多 agent 框架,发现 agent 之间协作很冗余,信息传递也不精确,幻觉率很高,卡了好几天。
后来发现,没必要用多agent啊,就去github上搜有没有现成的NL2SQL的开源框架(避免重复造轮子),发现VannaAI,魔改定制,完成了demo。